RTX 3060 Ti 8GBで63モデル実測 帯域幅の壁とMoEオフロードの実像
10秒でわかる内容解説
GitHubユーザーBBQ2077が2026年9月18日に公開したベンチマークレポートは、RTX 3060 Ti 8GB搭載PCで63種類のローカルLLMを実測した結果をまとめたものだ。
推論のボトルネックは演算能力ではなく帯域幅
環境はRTX 3060 Ti 8GBと32GB DDR4-2666 RAMで構成される。利用可能なメモリプールは約30GBだが、GPUメモリとシステムRAMの間には11倍の速度差がある。テストではコンテキスト4096とQ4KVを条件に、1000字の推理小説生成タスクを63回実行した。41モデルが正常に完了し、17モデルが無限ループまたはクラッシュした。5モデルは実行すらできなかった。
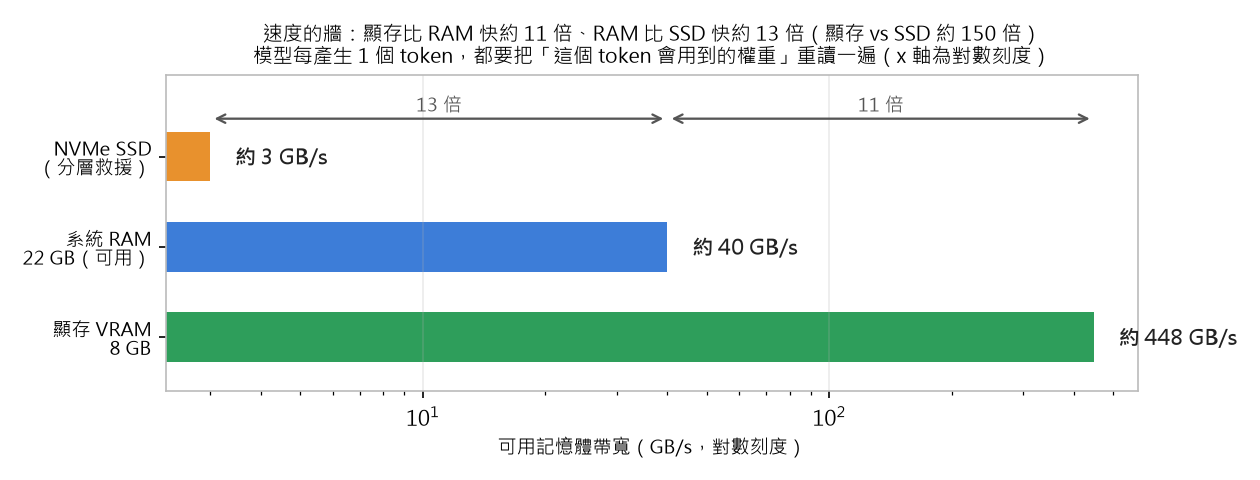
VRAM 448 GB/s vs system RAM ~40 GB/s vs SSD ~3 GB/s — once weights spill out of VRAM, every generated token costs ~11× more to read
GPUメモリは448 GB/s、RAMは約40 GB/s、SSDは約3 GB/sだ。重みがGPUメモリから溢れると、生成されるトークンあたりの読み込みコストは11倍になる
推論性能のボトルネックは演算能力ではなくメモリ帯域幅にある。GPUメモリの帯域幅は448 GB/sであるのに対し、RAMは実効で約40 GB/sにとどまる。モデルの重みがGPUメモリから溢れると、トークン生成あたりの読み込みコストが11倍に跳ね上がる。SSDにまで達すれば150倍になる。
容量が確保されても走れるかどうかは別の関門だ。63モデルのうち品質評価で明確な正解とされたのは2モデルのみだった。最高スコアは5.8で、6.0の及格線にはわずかに届かなかった。
この数値は8GB環境における推論の限界を示している。GGUFRun v2.0を用いた実測データは一字も改変されずアーカイブされている。帯域上限の推算と分組統計が補足された英文サマリーも併せて公開された。63筆のリストはCSVで提供され、実行結果と品質、速度、評語、リンク状態がソート可能だ。
MoEオフロードで大規模モデルを動かす限界
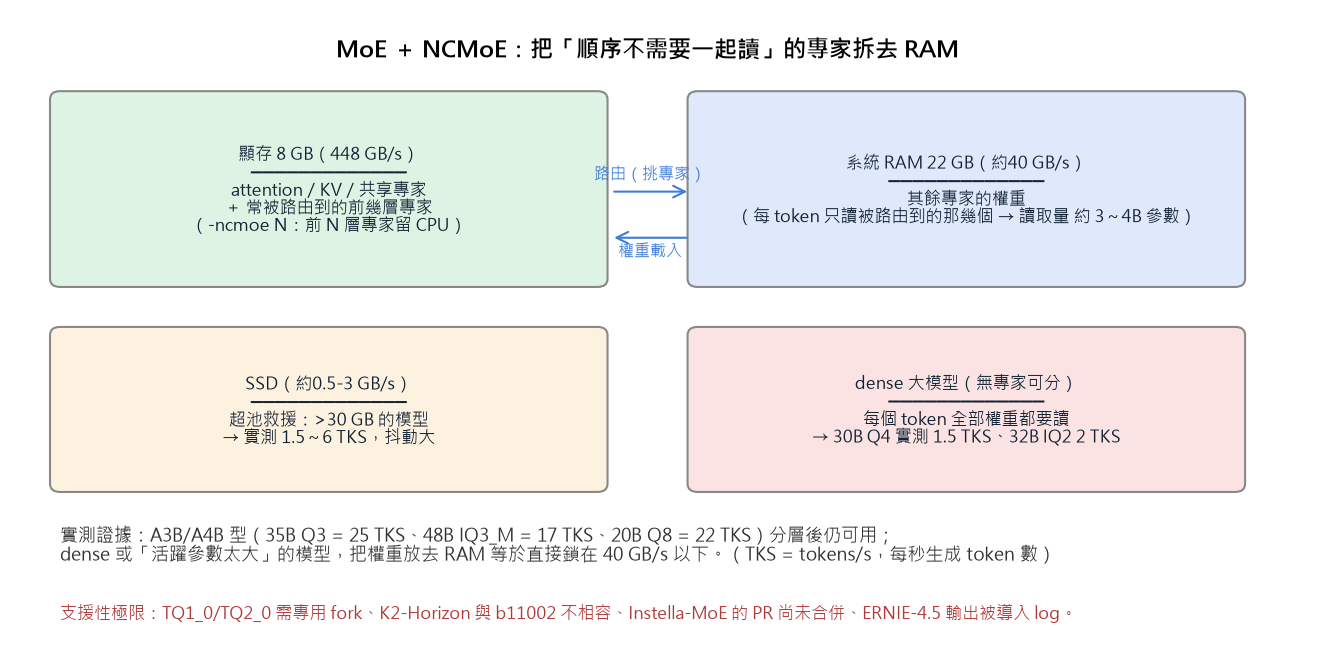
大規模モデルをこの環境で動かす唯一の突破口は、MoEアーキテクチャと`-ncmoe`オフロード機能の組み合わせだ。Expertsはパラメータの一部分であり、推論時に必要な場合のみ呼び出される仕組みだ。この設定を適用すると、35B Q3量化で25 TKS、48B IQ3_Mで17 TKS、20B Q8で22 TKSの推論速度が記録された。
一方、Denseモデルにはこのレバーが効かない。30B Q4量化はメモリに収まるものの、速度は1.5 TKSにとどまる。テストの限界は3つ存在する。
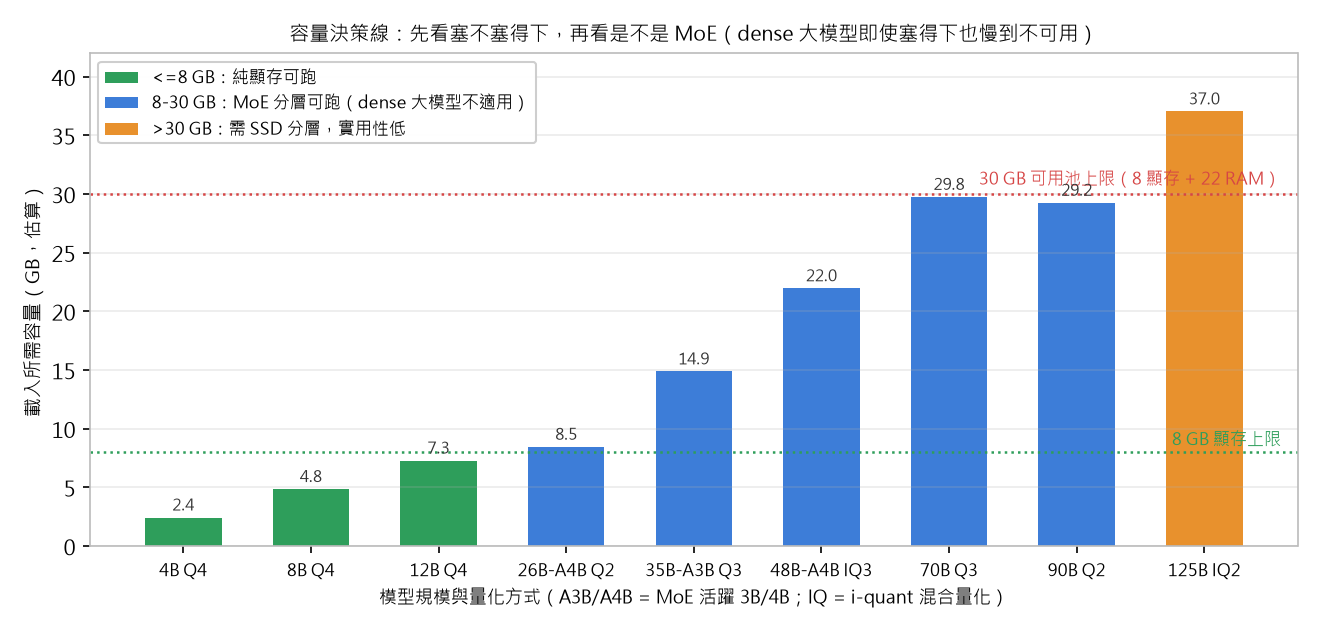
利用可能な30GBの容量上限によって45B Q4や70B Q3はKVキャッシュの余地がなくなる。Denseモデルには分割できるExpertsがない。そして一部フォーマットやアーキテクチャは既存のCUDAビルドと互換性がない。
最大の失敗モードは無限ループで、全体の27%を占めた。それは極低量化(Q1/Q2/IQ1/IQ2)と長出力、非中国語主語料または剪枝されたモデルに集中していた。大半はモデルそのものの欠陥ではなく、パラメータ設定とパイプラインの調整不足によるものだ。
無限ループを解消するための六つの対策がコスト順に提示されている。主報告書第6節では対策が整理され、第8節の意思決定ツリーが選型の手引きとなる。
GGUFRunによる再現性と互換性の制約
実測データの記録と可視化には、ウィンドウベースのフロントエンドGGUFRunが利用された。このツールは`llama-server`をラップし、MoEオフロードのスライダーやKVキャッシュの量子化、投機デコーディング、DRYサンプリングをGUIで操作できる。各モデルの最適パラメータはテンプレートとして保存され、再現性が確保されている。
公開されたデータセットは一字も改変されずアーカイブされている。チャート生成スクリプトを実行すると、同じデータからバイト単位の同一結果が得られる。63筆の実測値はmodels.csvで提供され、実行結果や品質、速度、評語、リンク状態がソート可能だ。
主報告書には容量と帯域のボトルネック解説が含まれる。信頼性を左右する要因も明示されている。異なるドライバー、CUDAビルド、llama.cppのバージョン、および背景負荷によって数値は変動する可能性がある。
また、19モデルのURLに疑点があり、特定の量子化形式(TQ1_0やTQ2_0)には専用フォークが必要など、アーキテクチャの互換性にも制限がある。一頁式儀表板にはKPIと六枚の図表が埋め込まれ、CC BY 4.0ライセンスで公開されている。
品質評価の現状と拡張テストの予定
品質評価はGPT-SOL基準で実施され、6.0が及格線とされた。明確な正解(A)と判定されたのは2モデルのみで、最高スコアは5.8だった。この数値は及格線にわずかに届かなかったため、8GB環境での実用ラインは依然として高いハードルを残している。
今後は63モデルの分類に基づいた意思決定ツリーが公開される予定だ。タスクの長さや用途に応じて、どの量化形式とオフロード設定を選ぶべきかの指針が示される。
特に1000字生成から3000字生成、またはコード生成や小ツールへの拡張テストが計画されている。報告書はCC BY 4.0ライセンスで提供され、データと図表の再構築が可能だ。
2026年9月18日に公開されたこの実測レポートは、ローカル推論の設計図として今後の検証基盤となる。原始実測記録はsource_llm_evaluation_4096_q4kv_report.mdに一字も改変されず保存されている。
make_charts.pyとmake_dashboard.pyを用いればチャートとダッシュボードを再描画できる。六枚のPNG図表も同時に公開され、英語圏の技術者向けに補足されている。