ローカルAIニュース:llama.cpp v1.0移行、RTX 30シリーズで推論高速化
20秒でわかる今日のニュース
- llama.cppがv1.0へ移行、RTX 30シリーズで並列推論が高速化
- DGX Spark向けQwen3.8レシピ、16ユーザー同時実行で高速化
- Debian 13ベースOS「AIRUX」、完全ローカル音声アシスタント搭載
- LLMアーキテクチャ変更の実験、細粒度MoEが最良
- Hermes Desktop用Claude Code GUIプラグイン、107種設定と承認
llama.cpp v1.0リリース、RTX 30シリーズ向け最適化
ggml-orgは2026年11月13日、llama.cppのメジャーバージョン1.0を正式リリースし、C言語APIの破壊的変更を採用した。RTX 30シリーズ以降のNVIDIA GPU向けに、2〜24トークンを同時に処理する新しいCUDAカーネルを実装した。
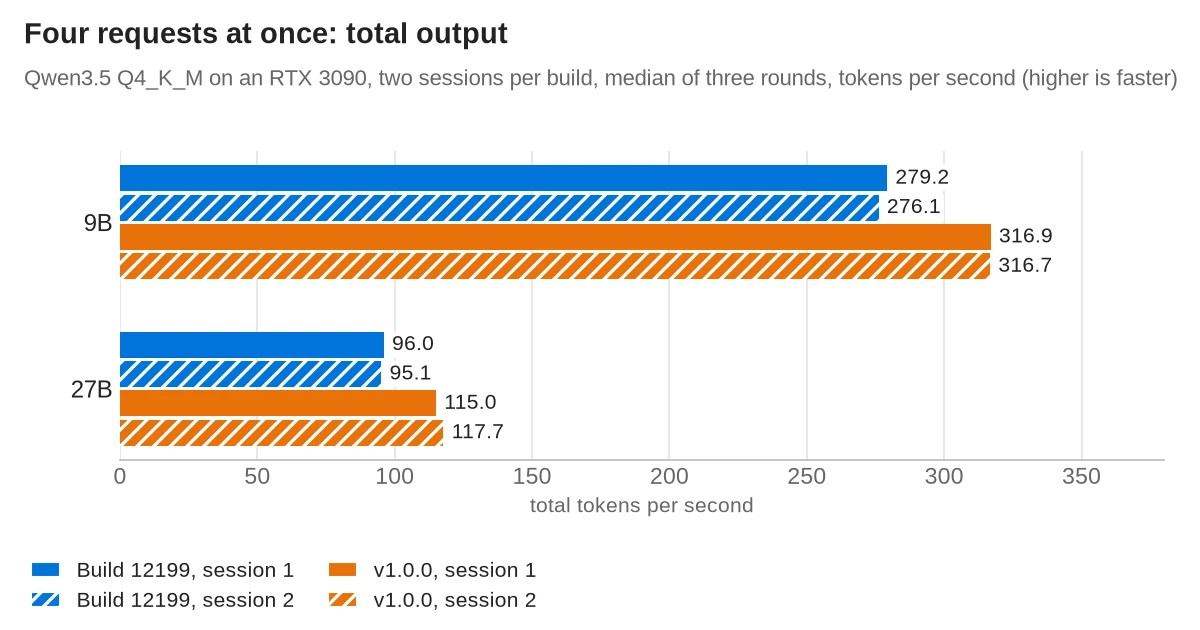
これにより、4つのリクエストを並列実行した際、9Bモデルで14%、27Bモデルで22%の生成速度向上を確認した。27Bモデルでスペキュラティブデコーディングを有効化すると、生成速度が52〜55%向上した。
旧バージョンから削除されたフラグがあるため、起動コマンドから--defrag-tholdを削除する必要がある。また、ネットワーク上のllama-serverはAPIキーを設定しないとツールが有効になる。Ollamaの最新リリースはまだ旧ビルドを使用しており、v1.0の高速化は今後のアップデートで反映される予定だ。セマンティックバージョニングにより、破壊的変更があればメジャーバージョンが上がる仕組みだ。
DGX Spark向けQwen3.8レシピ、16ユーザー同時実行で高速化
Picom-codeは2026年11月15日、NVIDIA DGX Spark上でQwen3.8-Flash-Nextを高速推論するレシピを公開した。TensorFoldエンジンとMiaAI-Labのレシピ、および29件の独自パッチを組み合わせ、公式FP4重みをそのまま使用している。
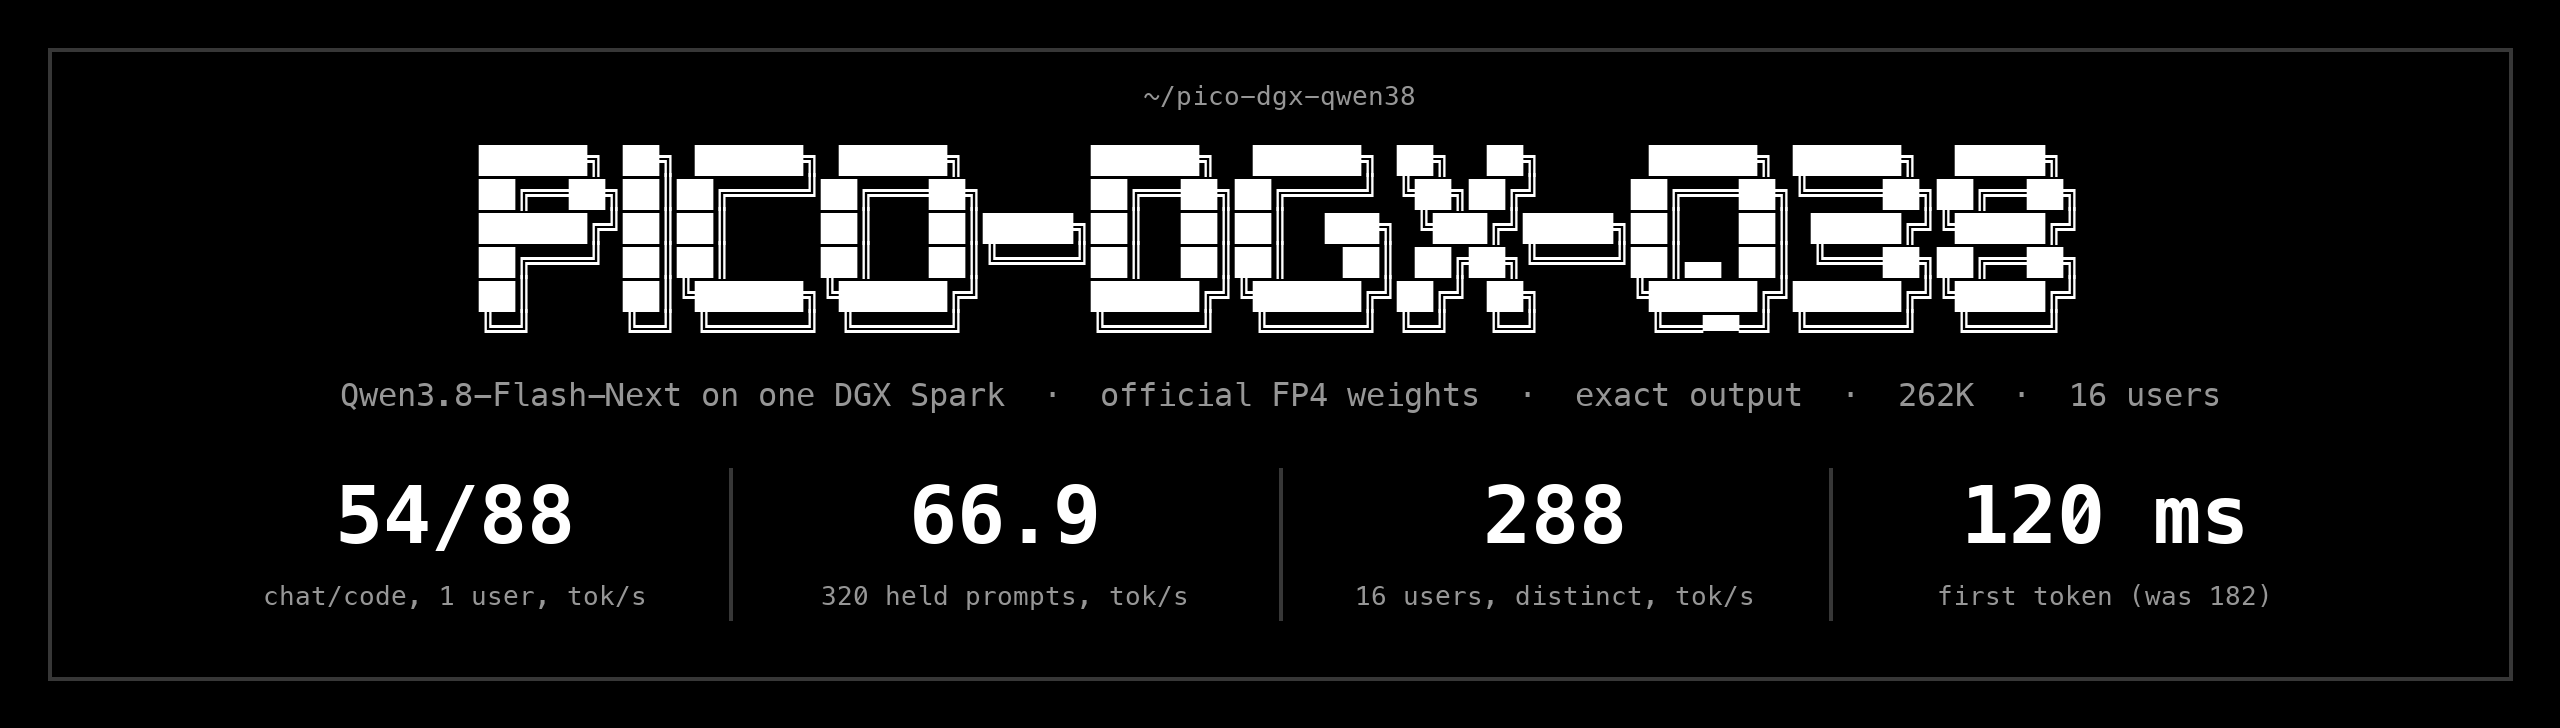
シングルユーザーでの推論速度はチャットが54トークン毎秒、コードが88トークン毎秒となった。16ユーザーが同時に実行した場合の合計出力速度は288トークン毎秒を記録した。KVキャッシュをbf16精度でExactに設定しており、推論品質の低下を防ぎつつ並列処理能力を高めている。
最適化レバーを全て有効にしても、ベースエンジンと完全一致のテキスト出力を確認した。10エージェント実行時にプロンプトキャッシュが不足する課題はあるものの、単一ボードでの大規模同時利用を可能にする実用的な構成だ。コンテキスト長は262Kトークンをサポートし、シード固定時のサンプリング結果も一致している。スパークダッシュの構造化テストでは、コード生成速度が163トークン毎秒に達した。
Debian 13ベースOS「AIRUX」、完全ローカル音声アシスタント搭載
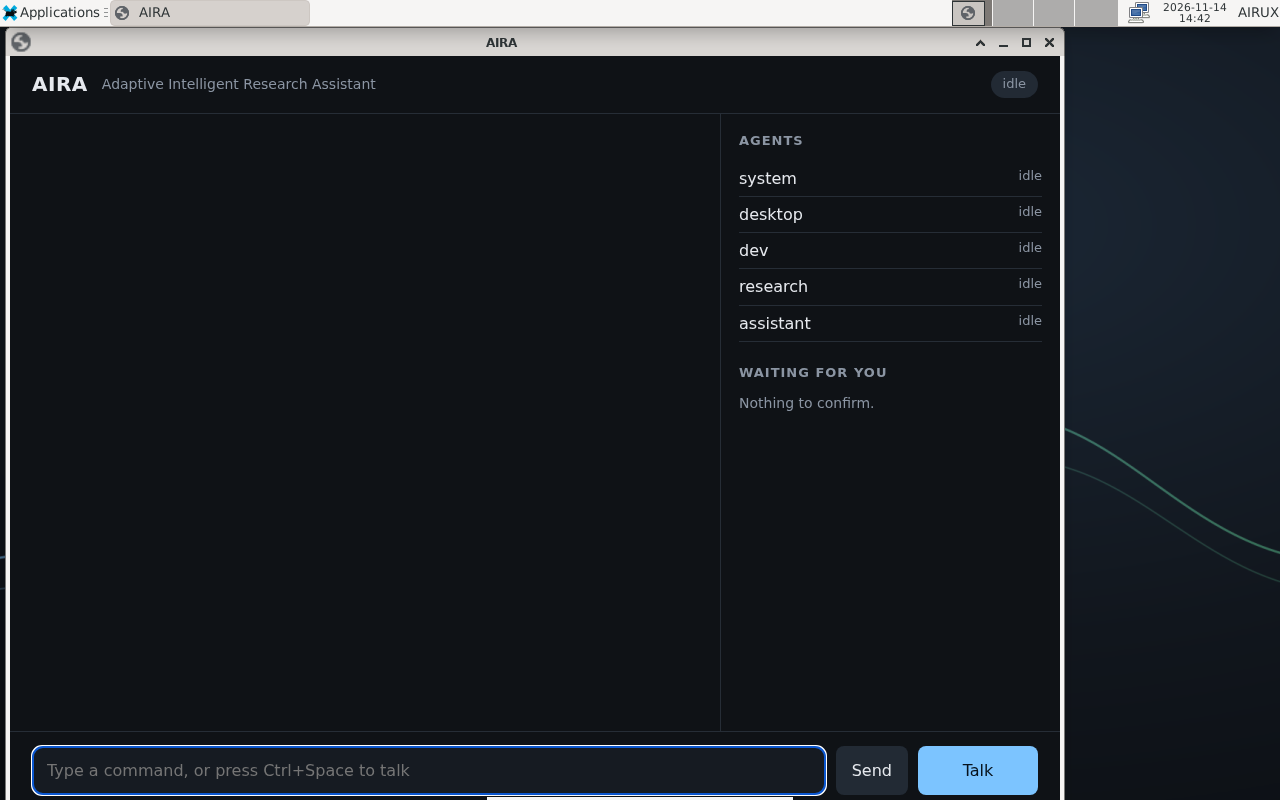
Absurd28は2026年11月15日、Debian 13をベースにした開発者向けOS「AIRUX」と、そのデスクトップに統合された音声アシスタント「AIRA」をGitHubで公開した。llama.cppでQwen3.5モデルを5つの専門エージェントに並列実行し、whisper.cppとKokoroで音声入出力を処理する。
グラウンディングガードとパーミッションブローカーにより、ツール呼び出しを厳密に検証する。200個の新コマンドで評価した結果、エラー率は2.5%に低下し、確認なしで実行されたリスクアクションはゼロだった。
起動時にRAMとVRAMを計測してモデルサイズを自動選択する設計で、現時点ではISOイメージがGitHubの制限を超えているためソースからのビルドが必要となる。暗号化されたメモリボルトを備え、キーワードやベクトル検索で過去の会話を参照できる。AIRAシェルのXfceウィンドウでは、ライブ文字起こしと保留中の確認をリアルタイムで確認できる。
LLMアーキテクチャ変更の実験、細粒度MoEが最良
ニキータ・パブリチェンコは2026年11月14日、2020年以降のLLMアーキテクチャ変更を1000回以上の実験で比較した結果を公開した。GPT-3ベースのモデルに対し、位置埋め込みや正規化、注意機構、MoEを単独および組み合わせで評価した。
細粒度MoEが単独変更で最も効果的であり、DeepSeek-V3の128エクスパート構成は損失を大幅に改善した。同等サービングコストではLatentMoEが最も高い改善率を示した。線形注意機構は単独では優れているが、MoEと組み合わせると差が縮まる。
GQAやMLAはKVキャッシュを4倍以上削減するため、同じ予算でより大きなモデルを運用できる。RoPEの優位性はスケールとともに縮小し、QK-normはすべてのモデル幅で約1%の品質向上をもたらした。推論スタックの最適化度合いによってサービングコストは変動するが、実用的な比較基準を示している。
出典:Hacker News
Hermes Desktop用Claude Code GUIプラグイン、107種設定と承認
MnemosyneOSは2026年11月15日、Hermes Desktop内で動作するグラフィカルなClaude Codeワークスペースを提供するプラグイン「claude-code-parity」をGitHubで公開した。実際のClaude CLIを子プロセスとして駆動するため、107種類の設定値をGUIで調整できる。
Anthropicのアカウントを持たなくても、ローカルブリッジ経由で動作し、Hermesに登録済みであれば任意のモデルを利用可能だ。1ターンごとに1プロセスの設計のため、MCPサーバーの接続はリセットされる。
ウィンドウ内または同じWi-Fiのスマホからツール承認を行え、英語と中国語のUIを切り替えられる。ブリッジはAnthropic形式とOpenAI形式を相互変換し、ゲートウェイ向けの追加ヘッダーやストリーム設定もyamlで定義できる。セッション履歴のアーカイブやドラッグアンドドロップによるファイル添付にも対応している。
出典
- Llama.cpp v1.0 on an RTX 3090: up to 55% faster with speculative decoding(Hacker News) · 議論
- Picom-code/pico-dgx-qwen38: Qwen3.8-Flash-Next on one DGX Spark, official NVIDIA FP4 weights, exact output: 54 chat / 88 code tok/s, 66.9 on 320 held prompts, 288 tok/s at 16 users. TensorFold + MiaAI-Lab recipe + 29 patches.(GitHub topic llm-inference)
- Absurd28/AIRUX_OS: AIRUX: a Debian 13 OS with AIRA, a fully local voice assistant (llama.cpp, whisper.cpp, Kokoro) that controls your system safely and won't make things up. 9-layer grounding guard, permission broker, encrypted memory.(GitHub topic local-llm)
- I Tried Every LLM Architecture Change Since 2020(Hacker News) · 議論
- MnemosyneOS/claude-code-parity: A graphical, non-terminal Claude Code workspace inside Hermes Desktop. Real claude CLI under the hood; any model Hermes already has.(GitHub topic local-llm)