ローカルAI(5ページ目)
-
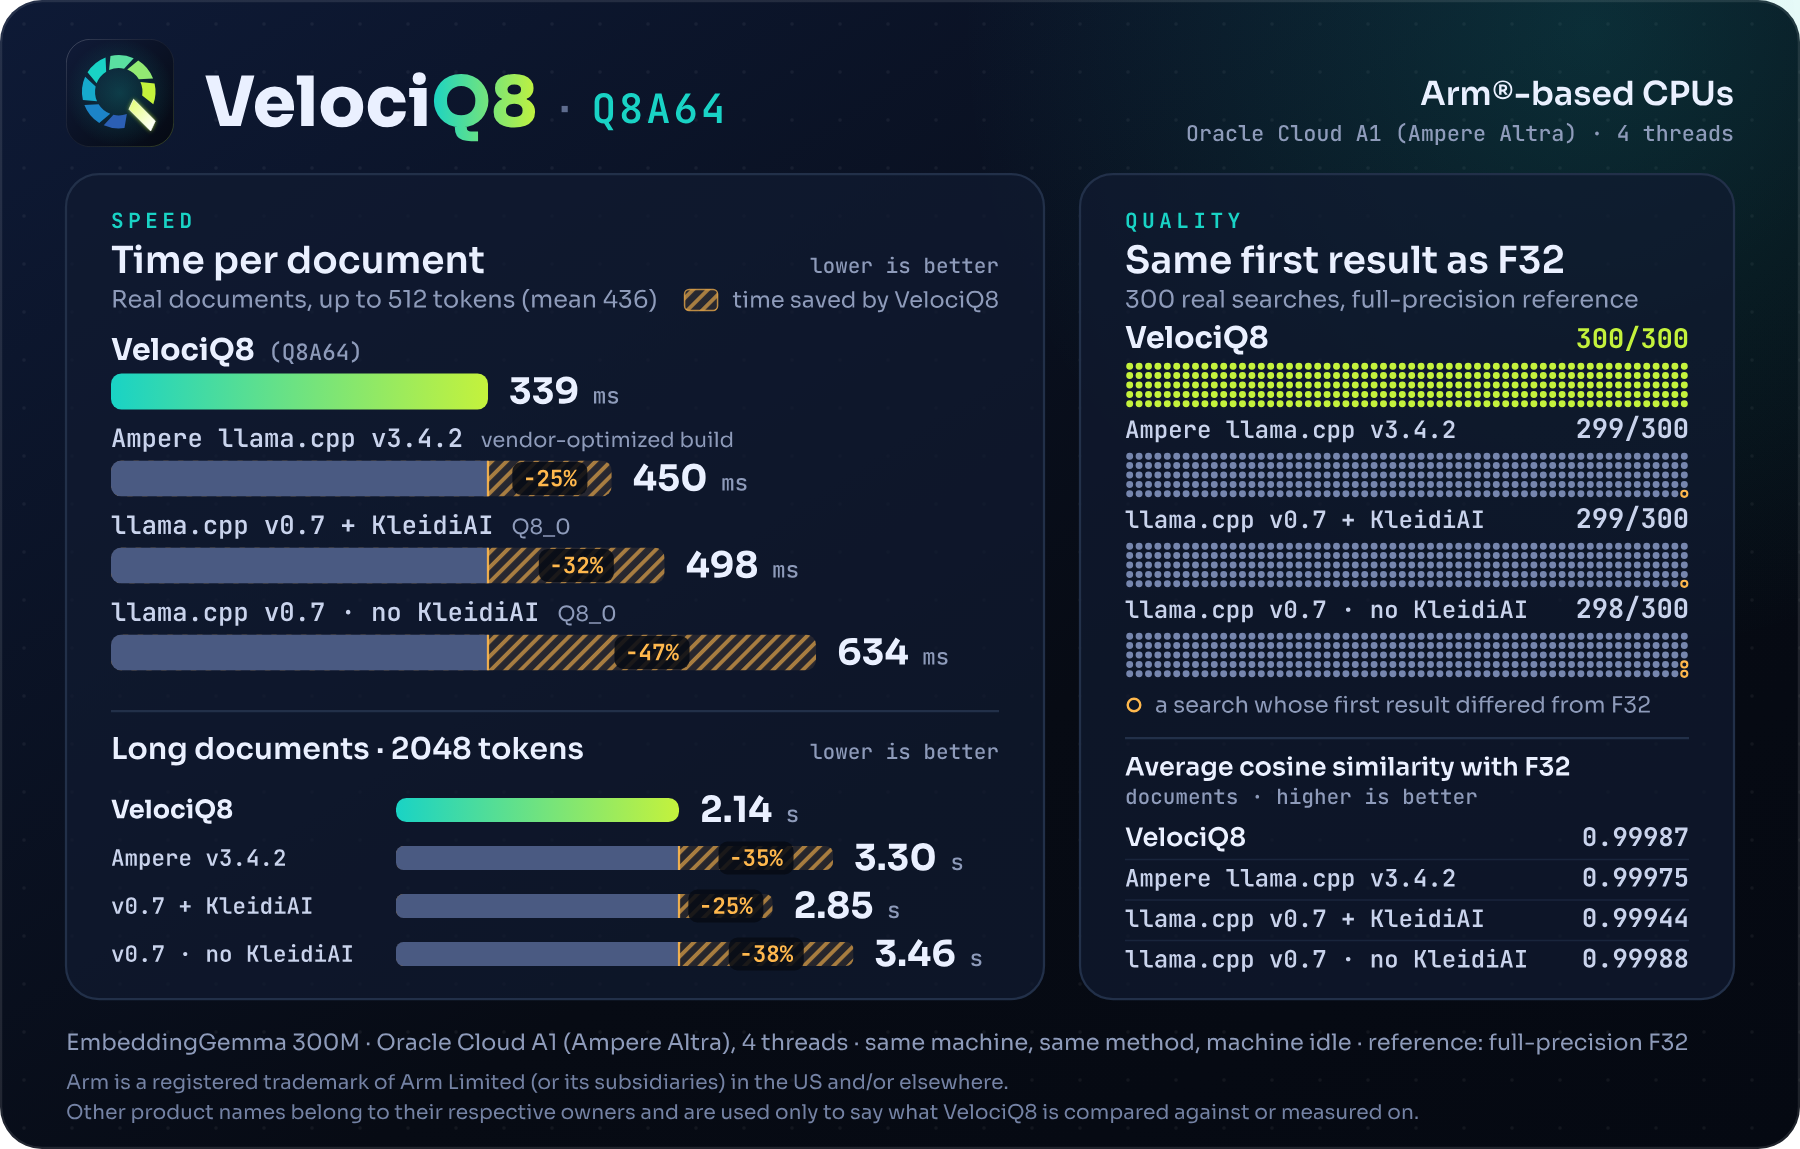
llama.cpp v0.7.0ベースの高速8ビット推論ビルド「VelociQ8」が公開
-
2台DGX Sparkで309BパラメータMiMo-V2.6をTensorFoldで推論する
-
DeepSeek-V4.1-Flash-1017の拒否挙動を解除したFP8版モデルが公開された
-
5万件の架空統計がChatGPTで7ヶ月引用され続けた実験の事実
-
HybridAgentsが潜在空間で推論するアーキテクチャをarXivに公開
-
RTX 5080 16GBでQwen3.5-27Bを完全GPU載せしたベンチマークとエージェント環境
-
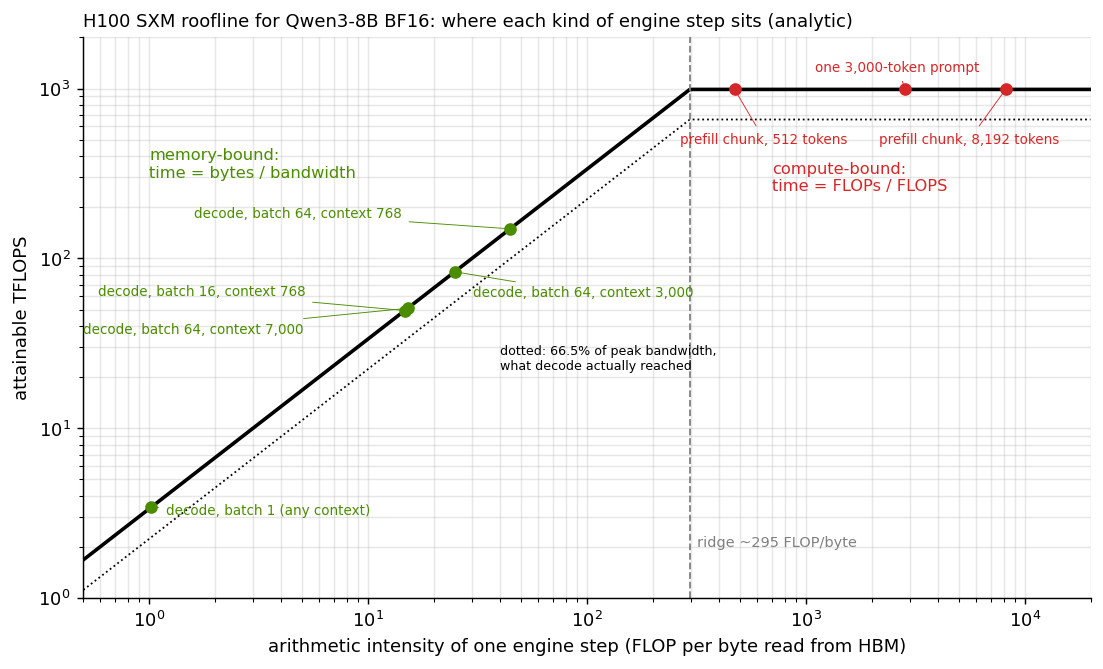
H100上でのLLM推論パフォーマンスを七つの実験で解析した
-
ローカルAI3基と物理端末で組んだAndroidアプリ自動検証パイプライン
-
GLM-5.3-Flashを4枚CMP 170HXで動かすレシピとベンチマーク結果
-
2枚のCMP 170HXで262KコンテキストのQwen3.8-Flash-Nextを稼働させるvLLMレシピ